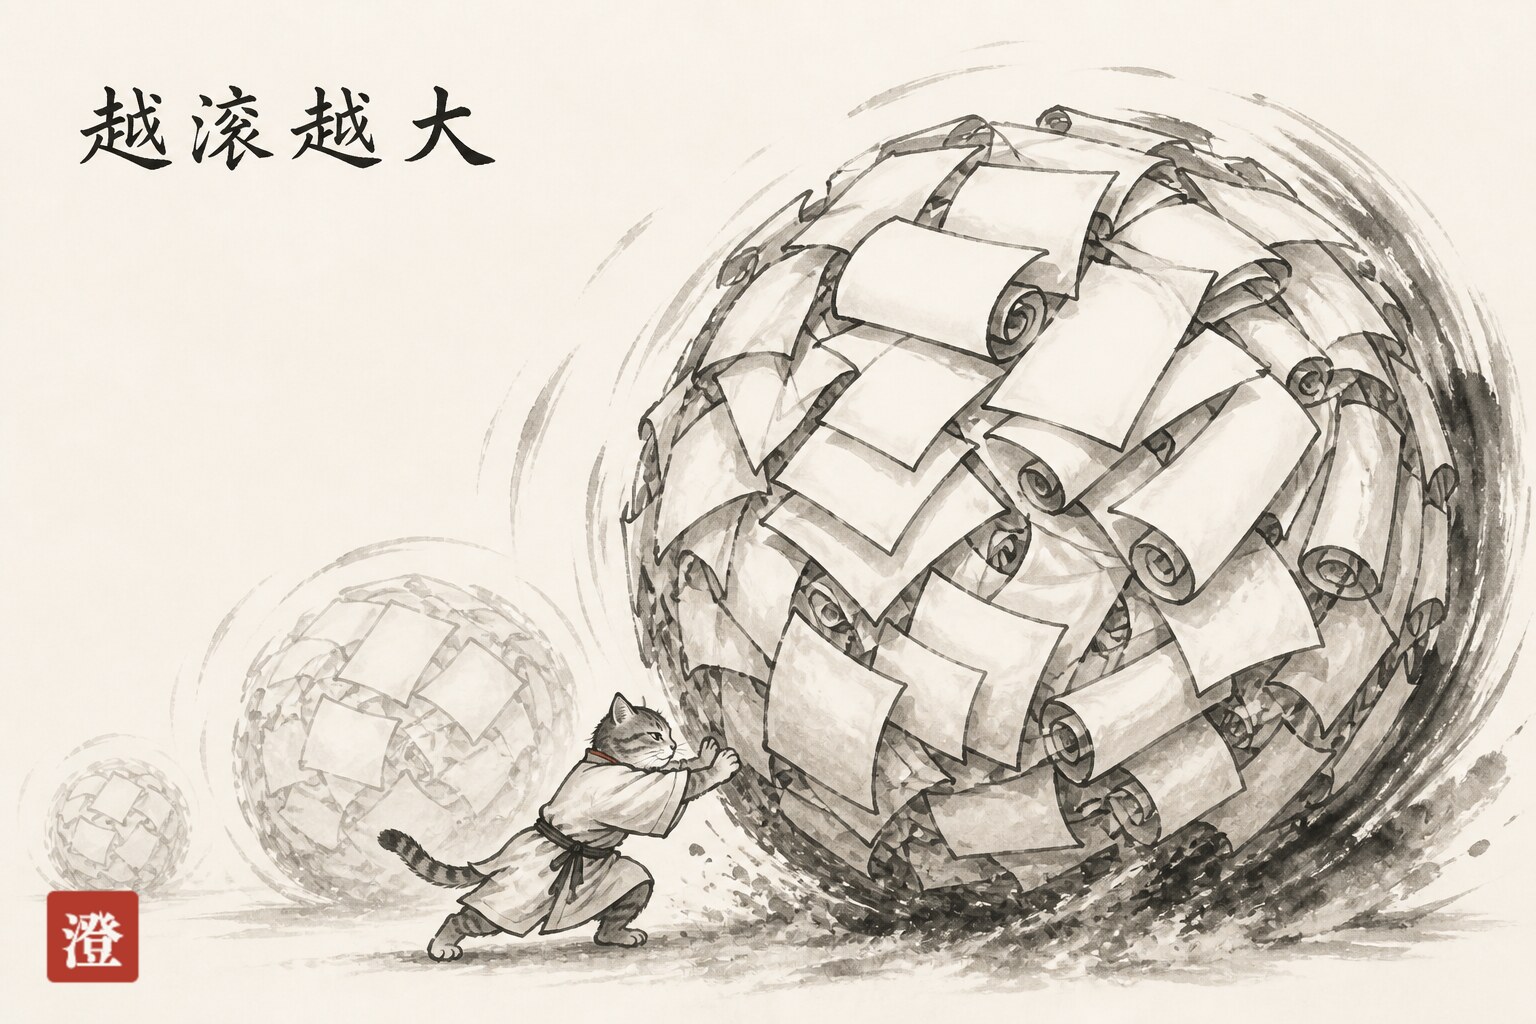
按下回车,你以为发给模型的是刚打的那句话。其实不是。这一课先让你看清:每一轮,agent 都把之前说过的全部、加上一整套规矩和工具,重新打包发一遍——而且越滚越大。
进入这一章之前,先破一个几乎人人都有的错觉。
你对着 agent 打字、按回车。你以为发给模型的,是你刚打的那句话。
不是。 发出去的,是从第一句到现在的全部对话,加上一整套”你是谁、该怎么做事”的规矩,加上”你手上有哪些工具”的清单——打包成一大坨,一起发。 而且下一轮,再来一遍,只会更大。
这一课不讲机制,就让你亲眼看它滚多大。
跟着一段对话,看它怎么滚
假设系统提示(那套规矩)约 800 token,工具清单约 1200 token,两样每轮都得带上。对话这样走(token 数是示意值,帮你找感觉):
| 轮次 | 这一轮新增的话 | 这次发出去的总量 |
|---|---|---|
| 第 1 轮 | 用户:“看看 login.ts”(~30) | 800 + 1200 + 30 ≈ 2k |
| 第 2 轮 | +assistant + 读到的文件(~2000) | 2k + 2000 ≈ 4k |
| 第 3 轮 | +grep 的一大堆输出(~3000) | 4k + 3000 ≈ 7k |
| …… | …… | 一路只涨不跌 |
| 第 10 轮 | +若干来回 | ≈ 25k |
两个立刻冒出来的问题
看懂了”每轮重发全部、越滚越大”,你脑子里应该已经蹦出两个问题——这一整章就是来回答它们的:
| 冒出来的问题 | 这一章怎么回答 |
|---|---|
| 一 · 怎么攒出来的? | 这一大坨里分几块、谁排前谁排后?—— 下一课 L1,把它摊成一份”三明治”。 |
| 二 · 不烧钱吗? | 系统提示传了 8000 token、早期历史反复重发——真实 agent 几乎不为这重复多花钱,靠的是 L2 讲的缓存。 |
而当这个雪球滚到模型装不下的那天(每个模型的”窗口”都有上限),又该怎么办?——那是 L3 的事:压缩。
带走这一句
你以为发的是”最后一句话”,其实每一轮都把”之前全部 + 规矩 + 工具”重新打包发一遍,而且只增不减、越滚越大。这一章就讲:这份东西怎么攒(L1)、为什么重发不烧钱(L2)、滚到装不下怎么压(L3)。
下一课
先回答问题一:把这一大坨摊开,看清它是哪几层拼的。你会发现,它和上一章那本账本,是同一件事的两半。